Next.js y WebMCP: la Skill que hace que tu sitio hable el lenguaje de los agentes IA
He pasado los últimos meses ensuciándome las manos con WebMCP en caprai.dev, y debo admitir que la experiencia ha sido reveladora. No en el sentido romántico del término, sino en el práctico: cometí errores, los corregí, y ahora sé exactamente qué se necesita para hacer que un sitio Next.js esté verdaderamente preparado para los agentes IA que viven en el navegador.
Cuando digo "agentes IA en el navegador" me refiero a esos asistentes que hoy comienzan a poblar Chrome, Edge y otros navegadores. Gemini que te observa mientras navegas, ChatGPT Desktop que intenta entender qué tienes delante. El problema es que estos agentes, hasta ayer, eran como turistas sin mapa: debían adivinar cómo funciona un sitio mirando su HTML, intentando interpretar botones, formularios y enlaces sin ninguna guía.
He creado una Skill
De toda esta experiencia he creado una Skill a través de la cual podrás guiar fácilmente a tu Coding Agent para estructurar un WebMCP para un proyecto Next.js y la puedes encontrar aquí https://github.com/capraidev/nextjs-webmcp
WebMCP: el protocolo que faltaba
WebMCP es el estándar que el W3C está definiendo para resolver este problema. La idea es simple pero poderosa: en lugar de dejar que el agente adivine, es el propio sitio quien declara qué puede hacer. ¿Puedo buscar contenidos? Sí, así es cómo. ¿Quiero leer un artículo? Usa esta herramienta. ¿Debo completar un formulario? Aquí están las reglas.
No es ciencia ficción, es pragmatismo. E implementarlo en Next.js, con todos sus mecanismos de renderizado y optimización, requiere un enfoque quirúrgico.
Un registro único: la lección más importante
El error que cometí en la primera iteración fue el que todos cometen: describir las herramientas en lugares diferentes. Una versión para el navegador, una para el servidor, una para llms.txt, quizás una cuarta para documentación futura. ¿El resultado? Divergencia garantizada en una semana.
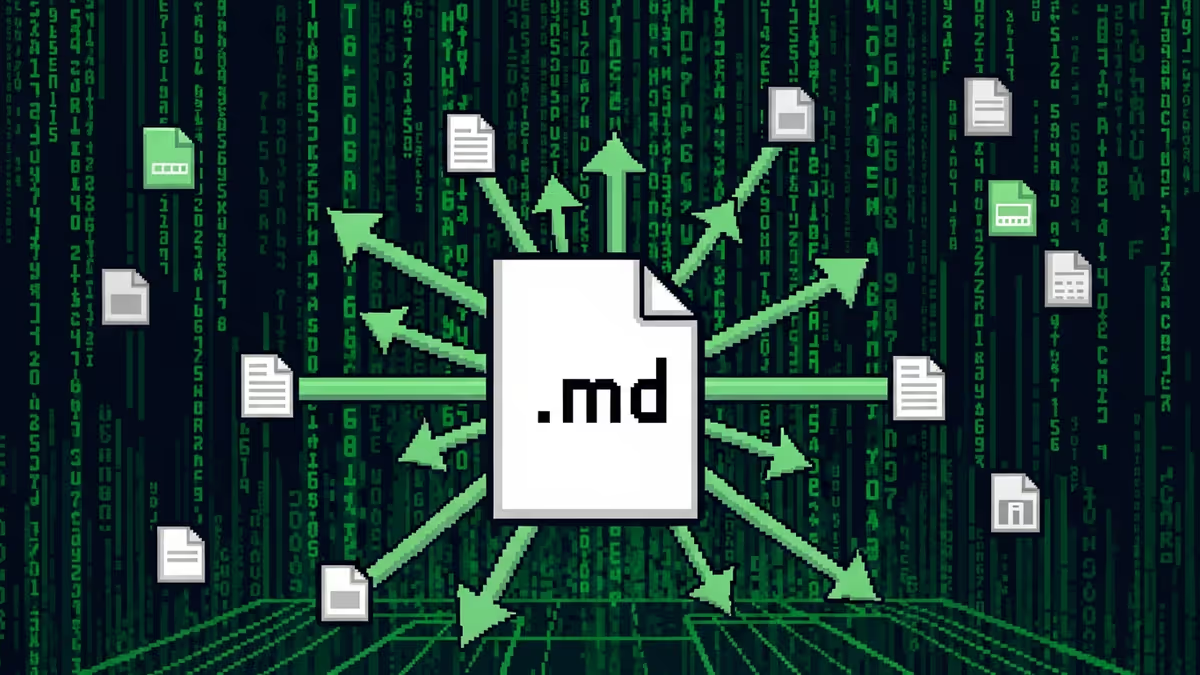
La solución que adopté es un registro único. Las herramientas se describen una sola vez, con esquema completo, reglas de validación y límites de uso. De ese registro central:
- Se generan las herramientas disponibles en el navegador
- Se alimenta la ruta API que las ejecuta del lado del servidor
- Se compila llms.txt para quien prefiere leer texto
- Se prepara el terreno para futuros endpoints MCP remotos
Cero duplicación, cero lógica dispersa. Cuando modificas una herramienta, el cambio se propaga a todos lados. Es el tipo de arquitectura que te hace dormir tranquilo.
Lecturas y escrituras: una distinción fundamental
Algo que aprendí observando el comportamiento de los agentes es que hay una diferencia sustancial entre leer y escribir. Las operaciones de lectura, buscar artículos, consultar un catálogo, son relativamente seguras. Respetan las reglas de acceso ya presentes, no modifican nada, no tienen consecuencias.
Las acciones con consecuencias reales, en cambio, permanecen donde deben estar: en los formularios visibles. El agente puede ayudarte a completarlos, puede sugerirte qué escribir, pero el botón "enviar" lo presionas tú. Persona física, responsabilidad física.
¿Suscripción al newsletter? El agente completa los campos, tú confirmas. ¿Mensaje de contacto? Mismo mecanismo. Pagos, registros, consentimientos para el tratamiento de datos: todo fuera, a propósito. No porque no se pueda hacer técnicamente, sino porque no se debe hacer éticamente.
Seguridad y privacidad: no son opcionales
La primera vez que lancé WebMCP en caprai.dev, PageSpeed me hizo notar inmediatamente problemas con la Content Security Policy. Los nonce, los Trusted Types, la Cross-Origin-Opener-Policy: todos aspectos que en una implementación apresurada se tiende a ignorar o eludir.
En cambio, deben enfrentarse de frente. La skill que desarrollé incluye indicaciones precisas sobre cómo hacer convivir WebMCP con una CSP rigurosa, cómo gestionar los nonce dinámicos en Next.js, cómo configurar los Trusted Types sin abrir agujeros.
Y luego están las protecciones básicas pero esenciales: ningún dato personal en las respuestas de las herramientas, rate limiting por IP para evitar abusos, validación estricta de los inputs para prevenir prompt injection. Son precauciones que parecen obvias en el papel, pero en la práctica requieren atención constante.
Del código a la producción: el recorrido completo
Una de las partes más delicadas fue la gestión del origin trial de Chrome y Edge. Para quien no lo sepa, WebMCP aún está en fase experimental, y para activarlo se necesita un token específico para el propio dominio. En Vercel, este token se configura como variable de entorno, con recordatorio de la fecha de vencimiento incluido.
He incluido en la skill:
- Templates TypeScript listos para adaptar a tu propio dominio
- Tests automatizados que verifican cada herramienta antes del deploy
- Controles que impiden regresiones silenciosas
- Scripts para verificar qué herramientas expone cada página
- Auditorías Lighthouse específicas para el "Agentic browsing"
Este último punto fue una revelación. Lighthouse ha introducido auditorías dedicadas para verificar qué tan amigable es un sitio hacia los agentes. Pasarlas todas requiere cuidado, pero el feedback es inmediato y valioso.
Los errores que me costaron tiempo
Vale la pena hablar también de qué no funcionó al primer intento. Intenté generar dinámicamente las herramientas WebMCP según el contexto de la página. Idea interesante, implementación desastrosa. Los agentes se confundían, las herramientas cambiaban entre un renderizado y otro, el caching se volvía una pesadilla.
Solución: herramientas estáticas, siempre las mismas, documentadas claramente. El contexto lo gestionas en los parámetros, no en la disponibilidad.
Otro error: confiar ciegamente en la validación del lado del cliente. Los agentes, por definición, evitan la interfaz visual. Si tu única validación es un formulario React, estás en problemas. Se necesita validación estricta del lado del servidor, con esquema explícito y mensajes de error claros.
Por qué hacerlo, y por qué hacerlo bien
Podrías preguntarte si vale la pena invertir tiempo en un estándar aún en definición. Mi respuesta, después de haberlo hecho, es sí. No porque WebMCP se convertirá seguramente en el estándar dominante, sino porque el enfoque que impone, declarar explícitamente las capacidades de tu sitio, es intrínsecamente sano.
Incluso si WebMCP fuera reemplazado por algo más mañana, tener un registro centralizado de las herramientas disponibles, validación rigurosa, separación clara entre lectura y escritura, todo esto sigue siendo valioso. Es arquitectura sólida disfrazada de implementación de un estándar.
Y luego está el hecho de que los agentes IA en el navegador llegaron para quedarse. Llamémoslos WebMCP, llamémoslos con otro nombre, pero la necesidad de interfazarse de modo estructurado con los sitios web no desaparecerá. Mejor estar preparados ahora, con una implementación limpia y verificada, que perseguir después.
El futuro es conversacional, pero debe ser seguro
La idea de una web donde los agentes pueden buscar, leer, ayudarte a completar formularios, es fascinante. Pero solo si se hace con criterio. Solo si la seguridad y la privacidad están integradas desde el día cero, no añadidas como parche después.
La skill que he desarrollado en caprai.dev representa exactamente esto: un recorrido completo, de los errores a la solución, para hacer que un sitio Next.js esté listo para este futuro. Con código de producción, tests, verificaciones, y sobre todo con la conciencia de dónde trazar los límites.
Porque sí, queremos que los agentes nos ayuden. Pero deben hacerlo respetando las reglas que nosotros, como creadores de experiencias web, decidimos imponer. WebMCP es la herramienta. Usarla bien es responsabilidad nuestra.